
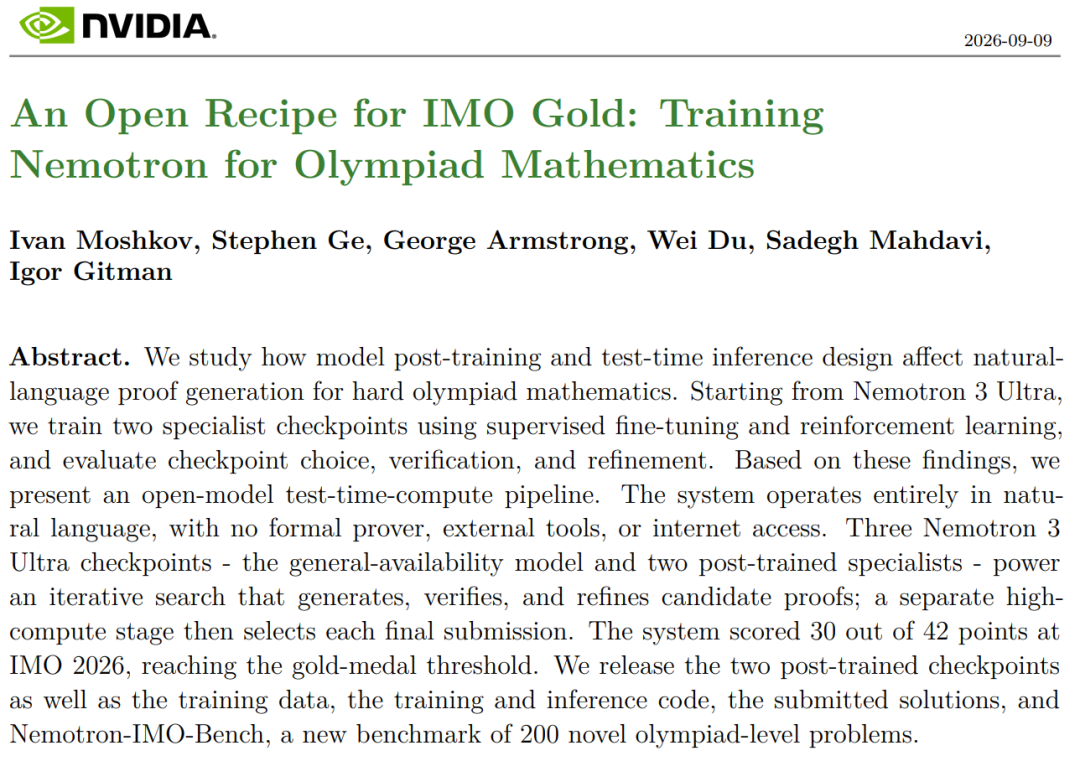
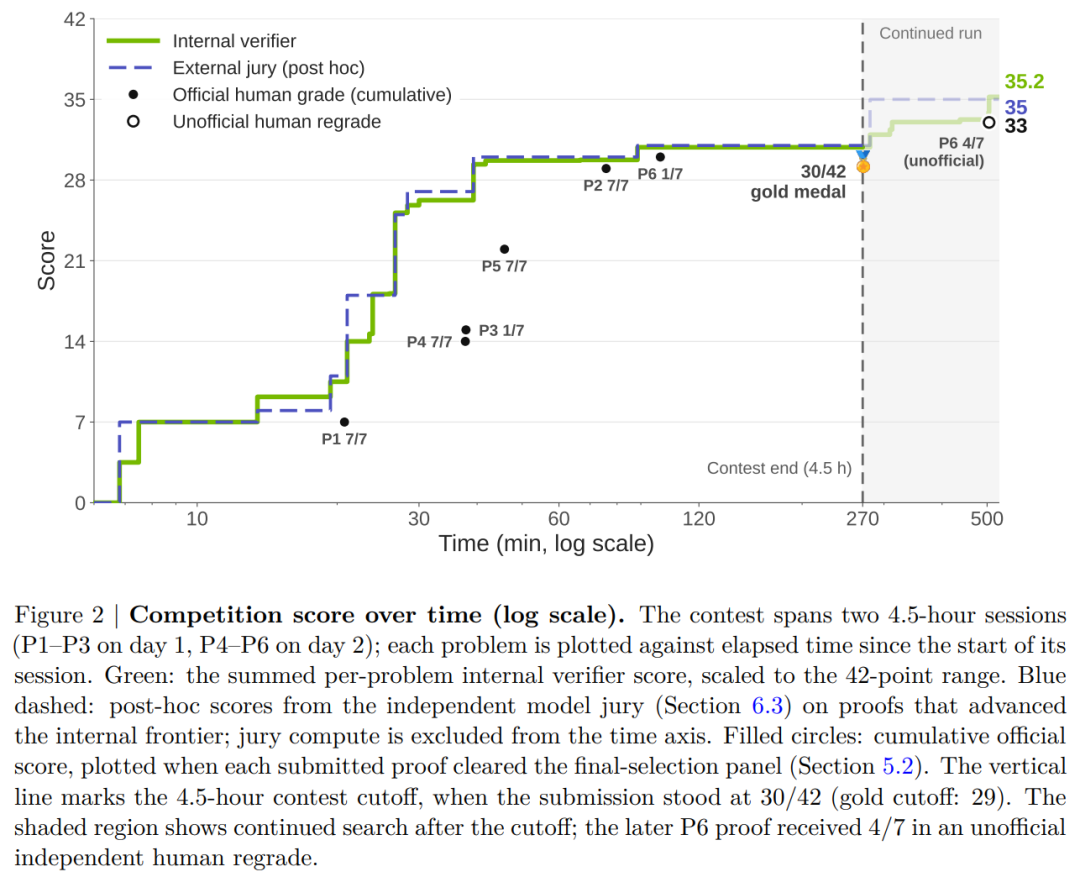
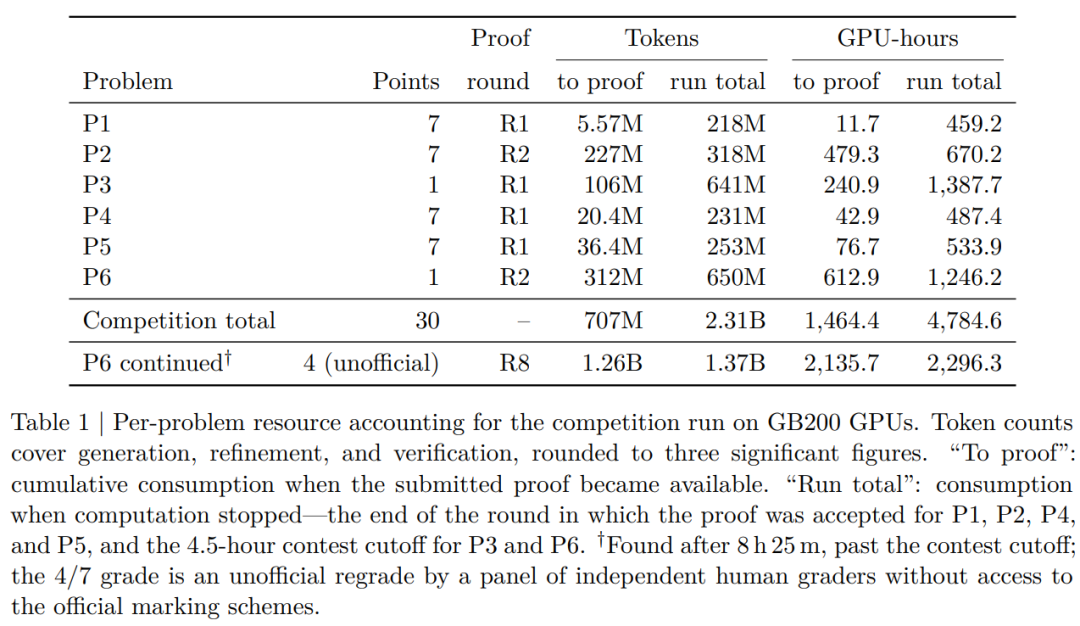
9 月 9 日,NVIDIA 正式公布了 Nemotron 3 Ultra 在 2026 年国际数学奥林匹克(IMO)竞赛中所使用的整套数学推理系统。该系统最终获得 30/42 分,成功超过当届 29 分的金牌分数线。与以往仅发布模型权重不同,此次 NVIDIA 开放了支撑这一成绩的完整技术栈,包括两个数学专家 checkpoint、SFT 与 RL 训练数据、推理代码、训练配方、比赛提交证明,以及新增的 200 道 Nemotron-IMO-Bench 题目。这一举措在 9 月 11 日陶哲轩、Peter Scholze 等 25 位菲尔兹奖得主批评 AI 数学成果缺乏复现时间点的背景下,显得尤为特殊,其核心在于将模型、数据、流程及计算成本全部公开,旨在平息学术界的疑虑并展示技术全貌。
双专家模型与搜索机制突破
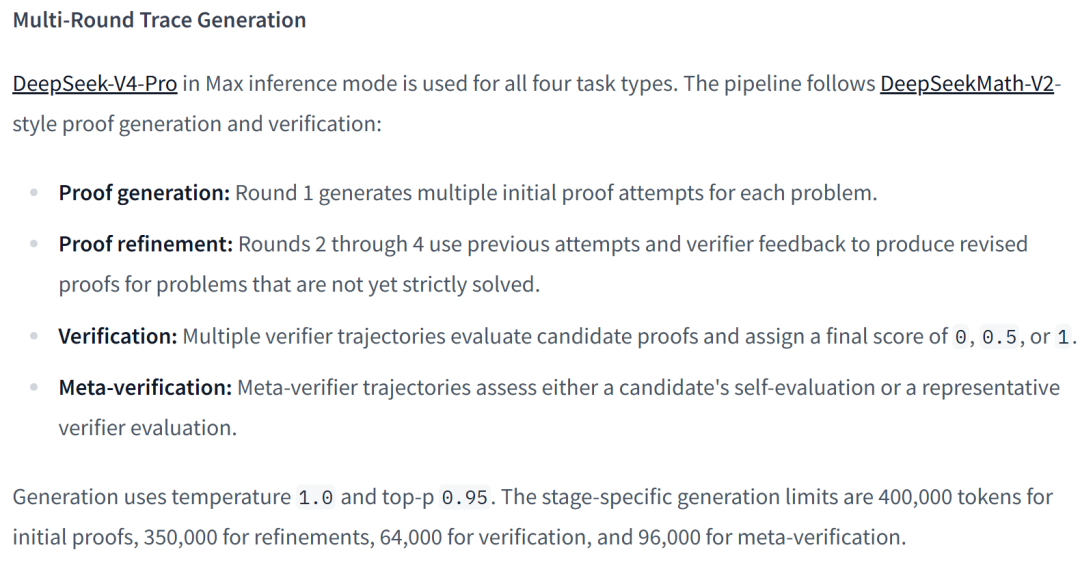
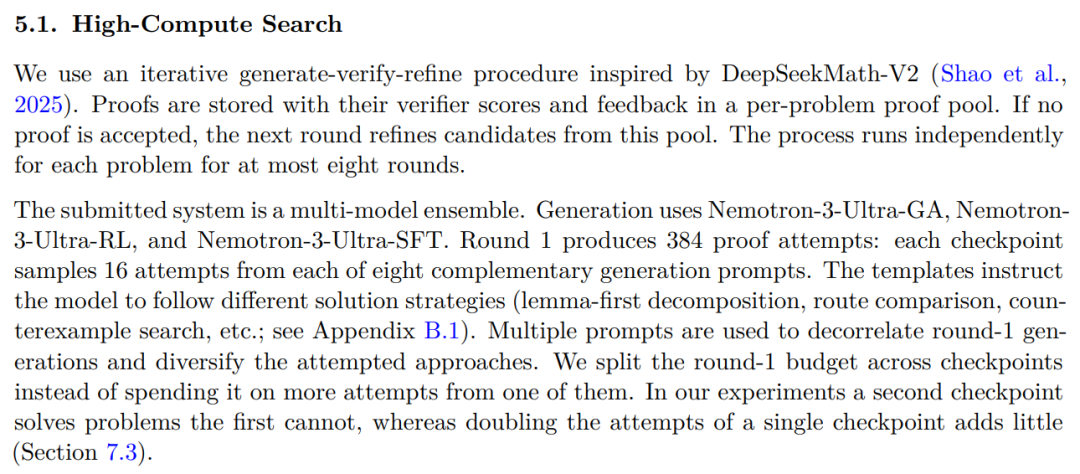
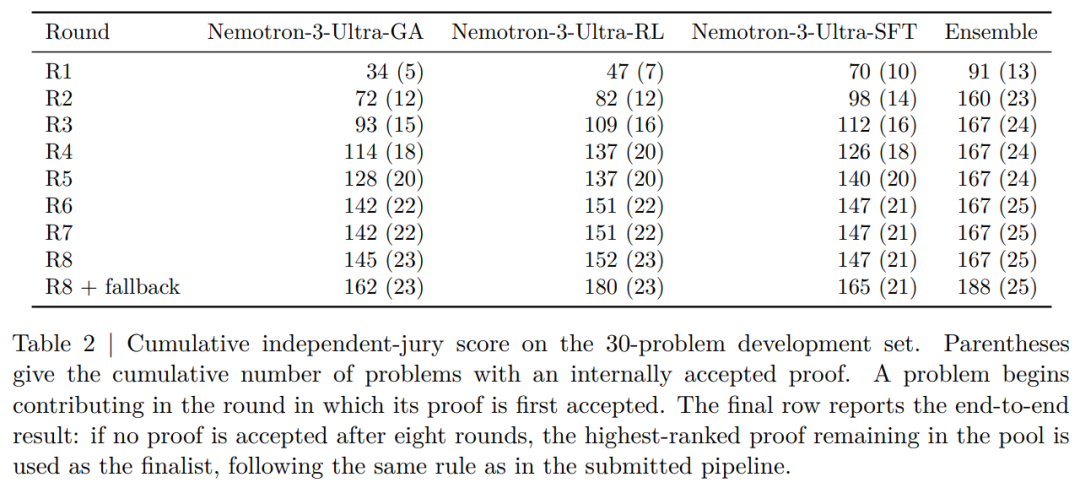
Nemotron 系统的核心创新在于摒弃了对单一模型反复采样的传统做法,转而训练了两个行为迥异的数学专家 checkpoint。其中一个经过 SFT 训练,专注于证明的修改、验证及纠错能力,能够基于已有证明的中间状态继续推进,从而保留前次计算的有效结构;另一个经过 RL 训练,旨在调整生成分布,提高正确证明路线被抽中的概率,压低导致死路的选择权重。
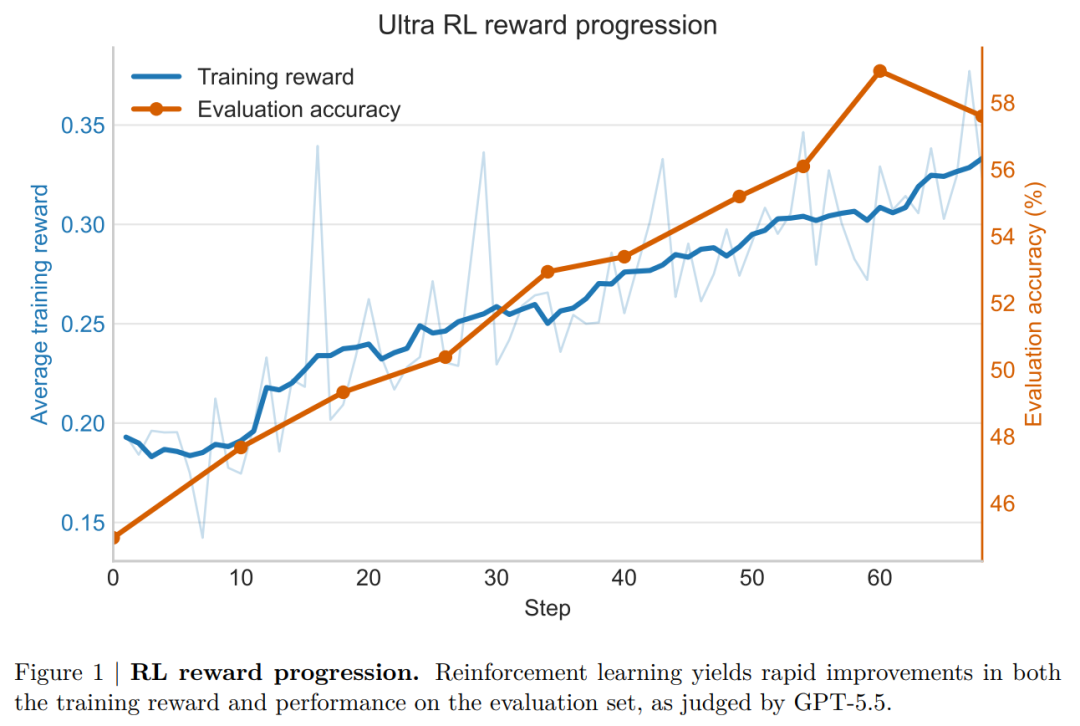
- SFT 专家:负责处理证明的局部错误,将已有证明作为中间状态继续修补,避免每次失败后重新进入整个证明空间。
- RL 专家:通过强化学习重新安排模型已有能力的出现频率,使能完整闭合证明的思路获得更高权重。
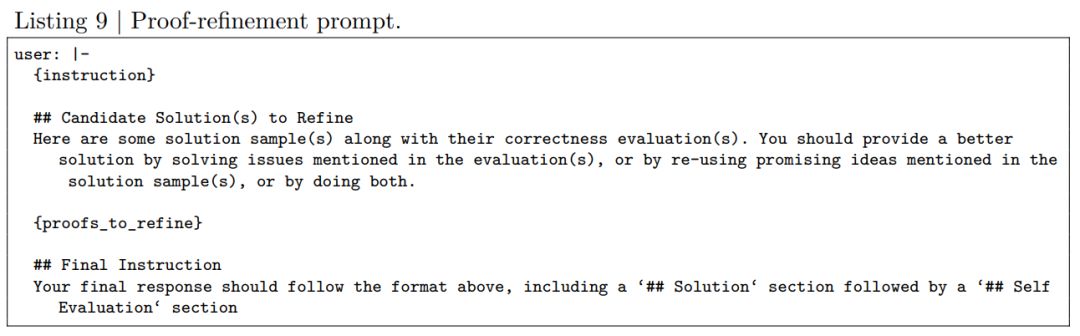
这种设计使得系统在首轮为每道题生成 384 份证明后,并非直接结束,而是将这些证明放入持续更新的“证明池”(Proof Pool)。系统根据验证器反馈,将高评分证明保留并送回模型进行多轮改写。这种机制实现了搜索宽度与深度的结合,动态决定计算资源投向,相比暴力采样能更有效地覆盖稀疏的证明空间。
验证困境与共享错误风险
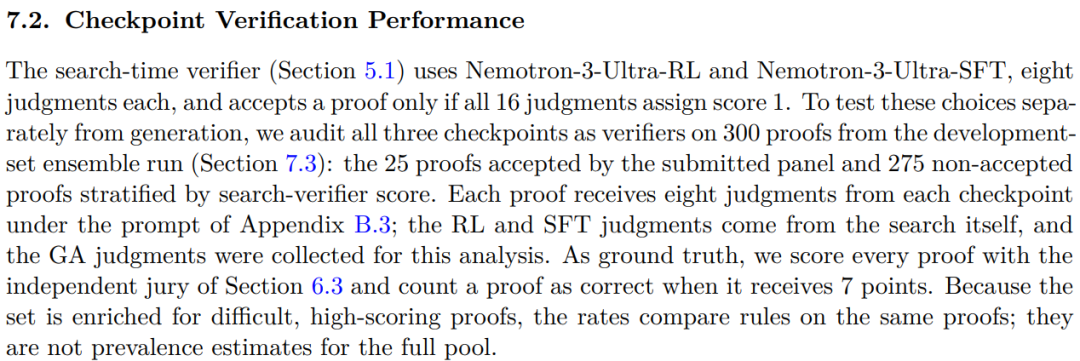
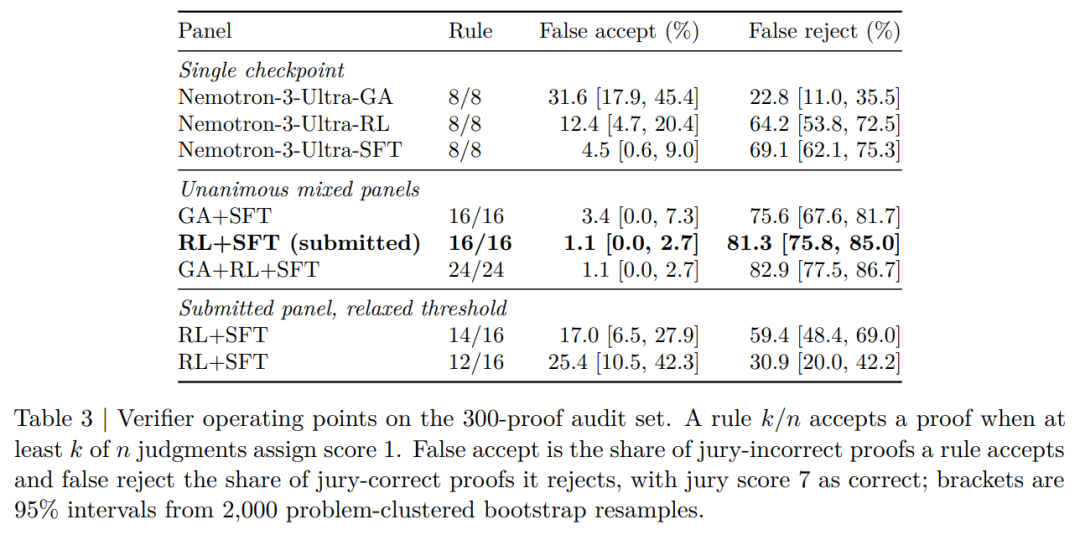
尽管系统设置了极高的接受门槛,要求两个专家反复检查且所有判断全部通过才接受证明,但实验揭示了深层挑战:验证判断并非完全独立。由于 SFT、RL 及通用版模型共享同一个 Nemotron 3 Ultra 底座,它们拥有相似的知识结构和推理习惯。当错误源于模型共同的理解盲区时,增加检查次数效果有限。例如,论文中提到的列置换对称性错误证明,存在明确反例,但三个 checkpoint 均未识别出漏洞,显示出错误的高度相关性。
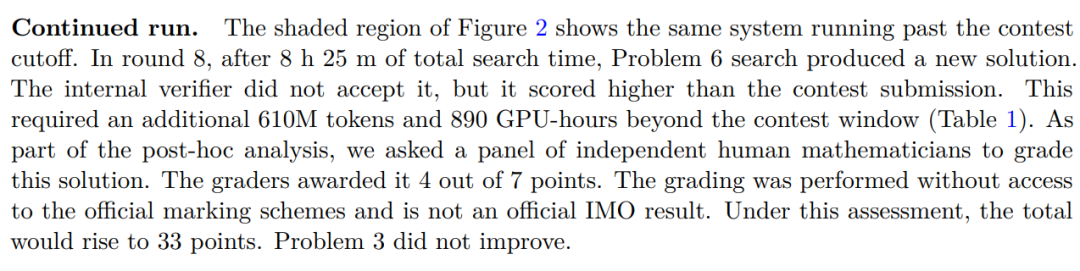
此外,验证器还面临两类偏差:一是错误证明因共享盲区被高置信度放行,二是高价值证明因门槛保守被误拒。第 6 题的案例显示,系统内部验证未放行的证明经人工复核后仍包含相当部分正确内容。这表明,未来技术路线不仅需训练更强的数学裁判,还需引入不同基础模型、反例生成器或形式化证明器,以打破验证组件间的错误相关性,降低同一位置同时失效的概率。
算力门槛引发的行业思考
NVIDIA 此次开源虽被视为“代码平权”,但支撑该系统运行的 1.5TB 显存需求构成了极高的硬件门槛。这一配置远超普通研究机构或中小企业的算力承受能力,使得复现该系统变得极具挑战性。在 AI 数学推理领域,算力规模往往决定了搜索的深度与广度,进而影响最终成绩。因此,此次发布被部分观点解读为“算力集权”的体现:虽然代码和数据开放,但只有拥有顶级算力资源的机构才能完整运行这一“金牌配方”。
这一事件反映了当前 AI 前沿探索中的核心矛盾:算法的透明化与算力壁垒的固化。对于行业而言,Nemotron 3 Ultra 的开源提供了宝贵的参考架构,明确了多专家协同、动态搜索池及多轮验证的技术路径。然而,1.5TB 显存的硬性要求提醒从业者,在追求模型智能极限的同时,算力基础设施的普及程度将是决定技术民主化进程的关键因素。未来,如何在降低算力消耗的前提下保持推理精度,或是通过异构计算、模型蒸馏等技术缩小算力差距,将成为学术界与工业界共同关注的焦点。